Dans la plupart des usines, on ne remarque la fiabilité que lorsqu’elle manque. La pompe qui lâche un vendredi soir, le convoyeur qu’on redémarre trois fois par quart, la presse qu’on n’ose plus pousser à pleine cadence. L’équipement fiable, lui, ne fait jamais parler de lui : il tourne. C’est précisément pour ça qu’on oublie de se demander pourquoi.
La fiabilité n’est pourtant ni une question de chance ni une question d’âge des machines. C’est une propriété qui se conçoit, se mesure et s’améliore. Ce guide fait le tour de la question : ce que le mot veut dire exactement, comment la mesurer sans se tromper, comment les pannes surviennent vraiment et quels leviers donnent les meilleurs résultats.
La fiabilité, définie mot par mot
La fiabilité est l’aptitude d’un équipement à accomplir sa fonction requise, dans des conditions données, pendant une durée donnée. Chaque morceau de cette définition compte.
- Sa fonction requise. Une pompe qui tourne mais ne livre plus le débit attendu est en défaillance, même si elle n’est pas « brisée ». Décrire la fonction, avec un seuil de performance, est la première étape de toute démarche de fiabilité : on ne peut pas améliorer ce qu’on n’a pas défini.
- Dans des conditions données. La même machine ne sera pas aussi fiable dans une salle propre qu’à côté d’un broyeur poussiéreux, ni à 60 % de sa capacité qu’au-delà de sa capacité nominale.
- Pendant une durée donnée. La fiabilité est une probabilité dans le temps : la chance qu’un équipement fonctionne sans défaillance pendant un quart, une campagne de production ou une année.
On la confond souvent avec deux notions voisines. La maintenabilité mesure la facilité à remettre un équipement en service après une panne. La disponibilité est la part du temps où il est prêt à produire, et elle découle des deux premières. Notre article sur la différence entre la fiabilité et la disponibilité détaille ces trois notions et leurs leviers respectifs.
La fiabilité se joue enfin à deux niveaux. La fiabilité inhérente est celle que permet la conception de l’équipement : ses matériaux, ses marges, l’environnement pour lequel il a été prévu. La fiabilité opérationnelle est celle qu’on obtient réellement, une fois l’équipement installé, exploité et entretenu. La maintenance ne peut pas dépasser la première. Elle décide toutefois, en grande partie, de l’écart entre les deux.
Pourquoi elle compte autant
Une panne coûte bien plus que sa réparation. Elle entraîne de la production perdue, des rebuts au redémarrage, des heures supplémentaires, des pièces commandées en urgence au prix fort. Elle crée aussi des risques : une intervention improvisée se fait sous pression, au moment précis où l’on est le plus tenté de prendre un raccourci.
Un équipement peu fiable a surtout un coût invisible : il dérègle tout le reste. Chaque panne bouscule le calendrier, repousse les travaux planifiés et nourrit le cercle vicieux du mode réactif, où l’on répare sans jamais avoir le temps de prévenir. À l’inverse, chaque panne évitée libère du temps pour la prévention. C’est pourquoi la fiabilité est souvent le meilleur point d’entrée pour sortir de la gestion de crise.
Pour donner un ordre de grandeur à la direction, commencez par chiffrer ce que vous coûte un arrêt avec notre calculateur du coût d’une heure d’arrêt. Le chiffre change souvent le ton des discussions budgétaires.
Mesurer la fiabilité sans se tromper
Trois mesures suffisent pour commencer, à condition de les calculer proprement.
Le MTBF, temps moyen entre défaillances
Le MTBF (de l’anglais Mean Time Between Failures) se calcule en divisant le temps de fonctionnement par le nombre de défaillances survenues pendant la même période :
MTBF = temps de fonctionnement ÷ nombre de défaillances
Prenons un exemple hypothétique : un compresseur a fonctionné 4 000 heures dans l’année et connu 5 défaillances. Son MTBF est de 800 heures. Plus le MTBF est élevé, plus les pannes sont espacées.
Le taux de défaillance
C’est l’inverse du MTBF : le nombre de défaillances par heure de fonctionnement. Pour le même compresseur, 5 ÷ 4 000 donne 0,00125 défaillance par heure. Le taux de défaillance devient utile quand on compare un parc d’équipements semblables, ou quand on additionne les risques de plusieurs composants montés en série : si un seul composant peut arrêter la machine, les taux s’additionnent.
La probabilité de fonctionner sans panne
C’est la définition même de la fiabilité : la probabilité qu’un équipement tienne une durée donnée sans défaillance. Quand les pannes surviennent au hasard, à un rythme à peu près constant, on l’estime avec la formule R(t) = e−t ÷ MTBF.
Toujours avec notre compresseur hypothétique, la probabilité de traverser une semaine de production de 120 heures sans panne est d’environ 86 %. Sur un mois de 500 heures de fonctionnement, elle tombe à environ 54 %. Le chiffre surprend souvent : un MTBF de 800 heures ne garantit pas du tout 800 heures sans panne. Une moyenne n’est pas une échéance.
Quatre conventions à fixer avant de calculer
- Ce qu’est une défaillance. Une perte totale ou partielle de la fonction requise. Un arrêt préventif planifié n’en est pas une, un ralentissement imposé par un défaut, oui.
- Le temps de référence. Des heures de fonctionnement (compteur, quarts travaillés), pas des heures de calendrier. Diviser toute l’année par le nombre de pannes gonfle le MTBF d’un équipement qui ne tourne que sur un quart.
- Le périmètre. L’équipement, un sous-ensemble ou toute une ligne : les chiffres ne se comparent qu’à périmètre égal.
- La source. Les bons de travail de la GMAO, avec un code de défaillance renseigné à chaque intervention corrective. Sans cette discipline, aucun calcul ne tient.
Pour aller plus loin sur le choix et l’usage des indicateurs, consultez notre guide sur les indicateurs de performance de maintenance.
Comment les pannes surviennent vraiment
La représentation la plus connue de la vie d’un équipement est la courbe en baignoire. Elle distingue trois périodes.
- Les défaillances de jeunesse. Juste après l’installation ou une remise à neuf, le taux de défaillance est élevé, puis il baisse. En cause : défauts de fabrication, erreurs de montage, mauvais alignement, rodage.
- La vie utile. Le taux est bas et à peu près constant. Les pannes y sont aléatoires et souvent provoquées par une cause extérieure : surcharge, contamination, erreur d’exploitation.
- L’usure. Le taux remonte avec la fatigue, la corrosion ou l’abrasion. C’est dans cette seule période qu’un remplacement à intervalle fixe a du sens.
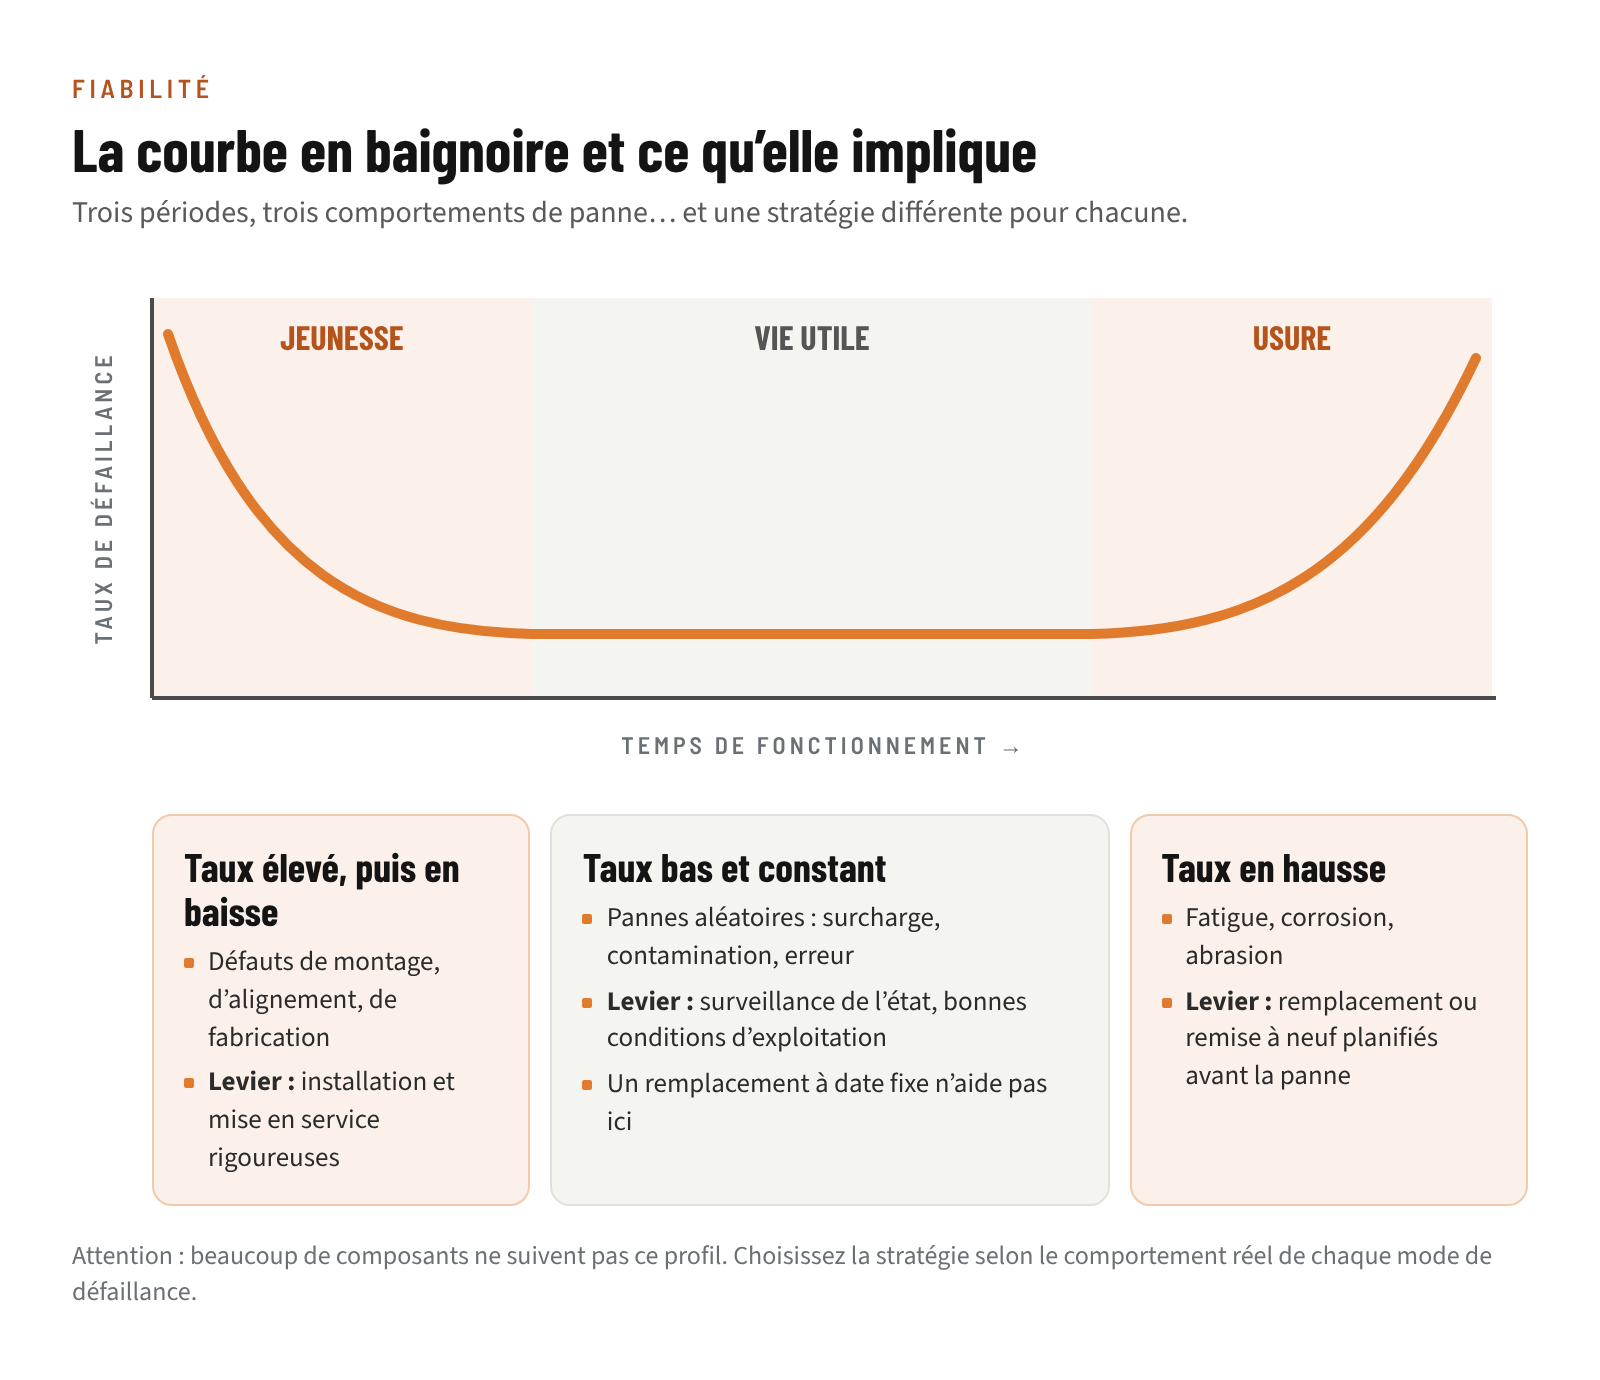
Cette courbe est utile, mais elle trompe si on la prend pour une loi universelle. Les études de fiabilité menées dans l’aviation civile, à l’origine de la maintenance basée sur la fiabilité (RCM), ont montré que la plupart des composants ne suivent pas ce profil. Beaucoup ne présentent aucune période d’usure nette : leurs pannes surviennent au hasard, ou peu après une intervention.
La conséquence pratique est importante. Remplacer une pièce à date fixe ne la rend pas plus fiable si ses pannes sont aléatoires, et peut même la rendre moins fiable en provoquant une défaillance de jeunesse à chaque remontage. Pour ces modes de défaillance, mieux vaut surveiller l’état de l’équipement (vibrations, thermographie, analyse d’huile, ultrasons) et intervenir quand les signes apparaissent. Notre article sur la maintenance conditionnelle explique comment s’y prendre.
Huit leviers pour améliorer la fiabilité
Les leviers se répartissent sur tout le cycle de vie de l’équipement. Les plus rentables se trouvent rarement là où on les cherche d’abord.
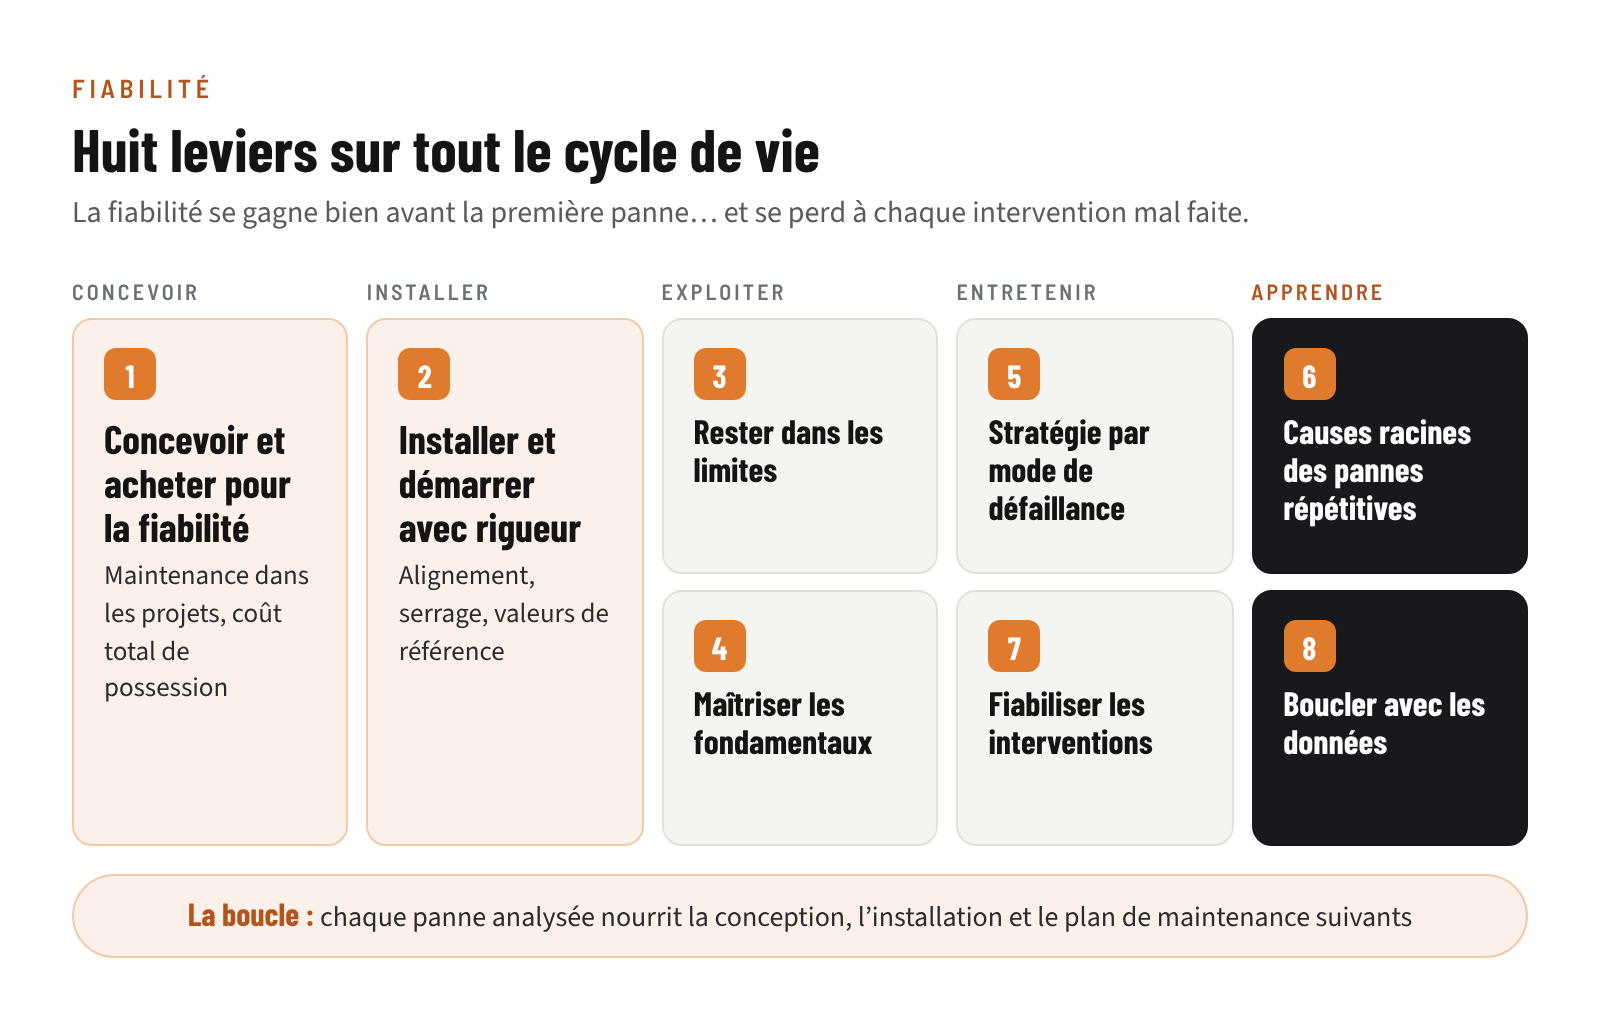
1. Concevoir et acheter pour la fiabilité
La fiabilité inhérente se décide avant même la mise en service. Associez la maintenance aux projets et aux achats : accès pour les inspections, standardisation des pièces, capteurs prévus d’origine, documentation complète. Comparez les offres sur le coût total de possession, pas seulement sur le prix d’achat. Un équipement moins cher qui exige deux fois plus d’interventions n’est pas une économie.
2. Installer et démarrer avec rigueur
Une bonne partie des défaillances de jeunesse se fabrique à l’installation : alignement approximatif, roulement monté au marteau, serrage au jugé, fondation insuffisante. Une mise en service encadrée par une liste de vérification, avec des valeurs de référence relevées dès le départ (vibrations, températures, courants), évite des mois de pannes « mystérieuses ».
3. Exploiter dans les limites de conception
Un équipement poussé au-delà de sa capacité, démarré et arrêté sans cesse ou utilisé hors de ses conditions prévues vieillit plus vite. Les opérateurs sont les premiers à voir les dérives. Formés à reconnaître les signes anormaux et à faire de petites inspections de routine, ils deviennent le premier niveau du système de fiabilité.
4. Maîtriser les fondamentaux
Lubrification, propreté, serrage, alignement, équilibrage : des sujets sans prestige, et pourtant à l’origine d’une part considérable des pannes mécaniques. Un programme de lubrification précis (bon lubrifiant, bonne quantité, bon intervalle, contamination maîtrisée) rapporte souvent plus vite que n’importe quelle technologie de pointe.
5. Choisir la bonne stratégie pour chaque mode de défaillance
Le préventif systématique n’est utile que pour les modes de défaillance liés à l’usure. Pour les autres, on surveille l’état, on cherche les défaillances cachées par des essais périodiques, ou l’on accepte de réparer à la panne quand ses conséquences sont mineures. C’est le principe de l’analyse des modes de défaillance et de leurs effets (AMDE) et de la maintenance basée sur la fiabilité. Notre guide pour bâtir un programme de maintenance basé sur les modes de défaillance détaille la méthode.
6. Éliminer les causes racines des pannes répétitives
Réparer la même panne pour la dixième fois n’est pas de la maintenance, c’est de l’habitude. Pour chaque panne répétitive ou coûteuse, remontez jusqu’à la cause qui, une fois corrigée, empêchera la récidive. Les « 5 pourquoi », l’arbre des causes ou le diagramme d’Ishikawa suffisent dans la plupart des cas. Voyez notre article sur l’analyse « why-why ».
7. Fiabiliser les interventions de maintenance
Chaque intervention est une occasion d’introduire un défaut : mauvaise pièce, joint pincé, serrage incorrect, saleté dans un circuit. Des procédures claires pour les tâches critiques, des pièces de qualité vérifiée et un contrôle avant la remise en service réduisent ces défaillances induites. Notre article sur les dix erreurs qui sabotent vos travaux en dresse la liste.
8. Boucler la boucle avec les données
Les sept premiers leviers ne tiennent que si l’on apprend de chaque panne. Exigez un code de défaillance sur chaque bon de travail correctif, examinez chaque mois les équipements qui causent le plus d’arrêts (un simple diagramme de Pareto suffit), suivez le MTBF de vos équipements critiques et vérifiez que les actions décidées ont eu l’effet attendu.
Par où commencer
Inutile de lancer un grand programme. Une démarche ciblée produit des résultats visibles en quelques mois et donne la crédibilité nécessaire pour aller plus loin.
- Choisissez de cinq à dix équipements critiques, ceux dont la panne touche la sécurité, la production ou la qualité.
- Fiabilisez les données : code de défaillance obligatoire sur chaque bon de travail correctif de ces équipements, dès maintenant.
- Établissez un point de départ : MTBF de chaque équipement et Pareto des pannes des six derniers mois.
- Attaquez les trois pannes les plus fréquentes par une analyse des causes racines, et suivez les actions jusqu’à leur réalisation.
- Revoyez le plan de maintenance de ces équipements, mode de défaillance par mode de défaillance : chaque tâche doit répondre à un mode précis.
- Mesurez de nouveau après quelques mois et partagez les résultats avec la production. Les gains visibles financent la suite.
Les pièges à éviter
- Répondre à chaque panne par plus de préventif. Ajouter des inspections sans viser un mode de défaillance précis alourdit la charge sans améliorer la fiabilité, et multiplie les occasions d’erreur.
- Confondre fiabilité et disponibilité. Une équipe qui répare vite peut afficher une bonne disponibilité sur un équipement qui casse sans arrêt. Regardez toujours le nombre de pannes à côté du temps d’arrêt.
- Valoriser les héros de la réparation. Si l’on ne récompense que les dépannages spectaculaires, personne n’a intérêt à ce que les pannes disparaissent. Célébrez aussi les pannes évitées.
- Viser le zéro panne partout. Certaines défaillances coûtent moins cher à réparer qu’à prévenir. La fiabilité consiste à concentrer l’effort là où les conséquences le justifient.
- Négliger la documentation. Sans codes de défaillance ni historique, chaque analyse repart de zéro et les mêmes erreurs se répètent d’une équipe à l’autre.
La fiabilité n’est pas un projet qu’on termine. C’est une habitude d’équipe : définir ce que l’équipement doit faire, mesurer honnêtement, comprendre chaque panne et corriger sa cause. Les usines qui y parviennent ne réparent pas forcément plus vite que les autres. Elles réparent moins souvent.
Pour une démarche concrète à l’échelle de l’usine (équipements critiques, stratégie, bases à consolider), lisez aussi Optimisez la fiabilité de vos équipements.
Ces enjeux sont au cœur des conférences et des visites d’usines du Congrès annuel de la maintenance industrielle, où des équipes d’ici présentent ce qui a fonctionné chez elles.